평균 10과 12, 표준편차 2인 정규분포에서 두 집단(각 50개)의 유전자 발현량을 만들어 t-검정을 하고, 결과를 상자그림과 점 그림으로 비교해 줘.
K
완료
실행 과정 18단계 · 34초
-
진행에이전트를 준비하고 있습니다.
-
진행질문에 맞는 도구와 데이터를 고르고 있습니다.
-
진행도구 1개, 데이터 0개, 라이브러리 9개를 골랐습니다.
-
계획분석 계획: 1. [ ] 재현 가능하도록 난수를 고정하고, 평균 10 및 12·표준편차 2인 정규분포에서 각 50개의 유전자 발현량을 생성합니다. 2. [ ] 독립표본 Welch t-검정을 수행하고 요약 통계와 검정 결과를 저장합니다. 3. [ ] 두 집단의 분포를 상자그림과 점 그림으로 비교한 그림 및 결과 표를 저장합니다.1. [✓] 재현 가능하도록 난수를 고정하고, 평균 10 및 12·표준편차 2인 정규분포에서 각 50개의 유전자 발현량을 생성합니다. 2. [ ] 독립표본 Welch t-검정을 수행하고 요약 통계와 검정 결과를 저장합니다. 3. [ ] 두 집단의 분포를 상자그림과 점 그림으로 비교한 그림 및 결과 표를 저장합니다.
-
코드 pythonpython
from biomni.tool.support_tools import run_python_repl result = run_python_repl(command=r''' import numpy as np import pandas as pd from pathlib import Path outdir = Path(".") rng = np.random.default_rng(2025) group1 = rng.normal(loc=10, scale=2, size=50) group2 = rng.normal(loc=12, scale=2, size=50) expression = pd.DataFrame({ "group": ["집단 1 (μ=10)"] * 50 + ["집단 2 (μ=12)"] * 50, "expression": np.r_[group1, group2] }) expression.to_csv(outdir / "simulated_gene_expression.csv", index=False, encoding="utf-8-sig") print("난수 시드: 2025") print("생성 데이터:", expression.shape) print(expression.groupby("group")["expression"].agg(["count", "mean", "std"]).round(3)) print("저장 완료: simulated_gene_expression.csv") ''') print(result) -
실행 결과
실행 결과 보기
난수 시드: 2025 생성 데이터: (100, 2) count mean std group 집단 1 (μ=10) 50 9.712 2.286 집단 2 (μ=12) 50 12.144 2.315 저장 완료: simulated_gene_expression.csv -
파일simulated_gene_expression.csv
-
계획생성된 표본의 관측 평균은 각각 9.712와 12.144입니다. 다음으로 분산을 동일하다고 가정하지 않는 Welch 독립표본 t-검정과 효과크기(Cohen’s d)를 계산하겠습니다. 1. [✓] 재현 가능하도록 난수를 고정하고, 평균 10 및 12·표준편차 2인 정규분포에서 각 50개의 유전자 발현량을 생성합니다. 2. [ ] 독립표본 Welch t-검정을 수행하고 요약 통계와 검정 결과를 저장합니다. 3. [ ] 두 집단의 분포를 상자그림과 점 그림으로 비교한 그림 및 결과 표를 저장합니다.
-
코드 pythonpython
from biomni.tool.support_tools import run_python_repl result = run_python_repl(command=r''' import pandas as pd import numpy as np from scipy import stats from pathlib import Path df = pd.read_csv("simulated_gene_expression.csv", encoding="utf-8-sig") groups = df["group"].unique() x = df.loc[df["group"] == groups[0], "expression"].to_numpy() y = df.loc[df["group"] == groups[1], "expression"].to_numpy() test = stats.ttest_ind(x, y, equal_var=False) n1, n2 = len(x), len(y) mean1, mean2 = x.mean(), y.mean() sd1, sd2 = x.std(ddof=1), y.std(ddof=1) difference = mean2 - mean1 se = np.sqrt(sd1**2/n1 + sd2**2/n2) df_welch = (sd1**2/n1 + sd2**2/n2)**2 / ((sd1**2/n1)**2/(n1-1) + (sd2**2/n2)**2/(n2-1)) tcrit = stats.t.ppf(0.975, df_welch) ci_low, ci_high = difference - tcrit*se, difference + tcrit*se pooled_sd = np.sqrt(((n1-1)*sd1**2 + (n2-1)*sd2**2)/(n1+n2-2)) cohens_d = difference / pooled_sd summary = pd.DataFrame({ "group": groups, "n": [n1, n2], "mean": [mean1, mean2], "sd": [sd1, sd2] }) test_results = pd.DataFrame([{ "test": "Welch independent-samples t-test (two-sided)", "comparison": f"{groups[1]} - {groups[0]}", "mean_difference": difference, "t_statistic": test.statistic, "degrees_freedom": df_welch, "p_value": test.pvalue, "ci_95_lower": ci_low, "ci_95_upper": ci_high, "cohens_d": cohens_d }]) summary.to_csv("gene_expression_summary.csv", index=False, encoding="utf-8-sig") test_results.to_csv("ttest_results.csv", index=False, encoding="utf-8-sig") print("집단 요약:") print(summary.round(3).to_string(index=False)) print("\nWelch t-검정:") print(test_results.round(4).to_string(index=False)) print("\n저장 완료: gene_expression_summary.csv, ttest_results.csv") ''') print(result) -
실행 결과
실행 결과 보기
집단 요약: group n mean sd 집단 1 (μ=10) 50 9.712 2.286 집단 2 (μ=12) 50 12.144 2.315 Welch t-검정: test comparison mean_difference t_statistic degrees_freedom p_value ci_95_lower ci_95_upper cohens_d Welch independent-samples t-test (two-sided) 집단 2 (μ=12) - 집단 1 (μ=10) 2.4326 -5.2868 97.9843 0.0 1.5195 3.3457 1.0574 저장 완료: gene_expression_summary.csv, ttest_results.csv -
파일gene_expression_summary.csv
-
파일ttest_results.csv
-
계획검정 결과, 두 집단의 평균 유전자 발현량 차이는 2.433이며, 집단 2가 더 높았습니다. Welch t-검정의 양측 p값은 매우 작아(반올림 시 0.0으로 표시됨) 통계적으로 유의합니다. 시각화를 생성하겠습니다. 1. [✓] 재현 가능하도록 난수를 고정하고, 평균 10 및 12·표준편차 2인 정규분포에서 각 50개의 유전자 발현량을 생성합니다. 2. [✓] 독립표본 Welch t-검정을 수행하고 요약 통계와 검정 결과를 저장합니다. 3. [ ] 두 집단의 분포를 상자그림과 점 그림으로 비교한 그림 및 결과 표를 저장합니다.
-
코드 pythonpython
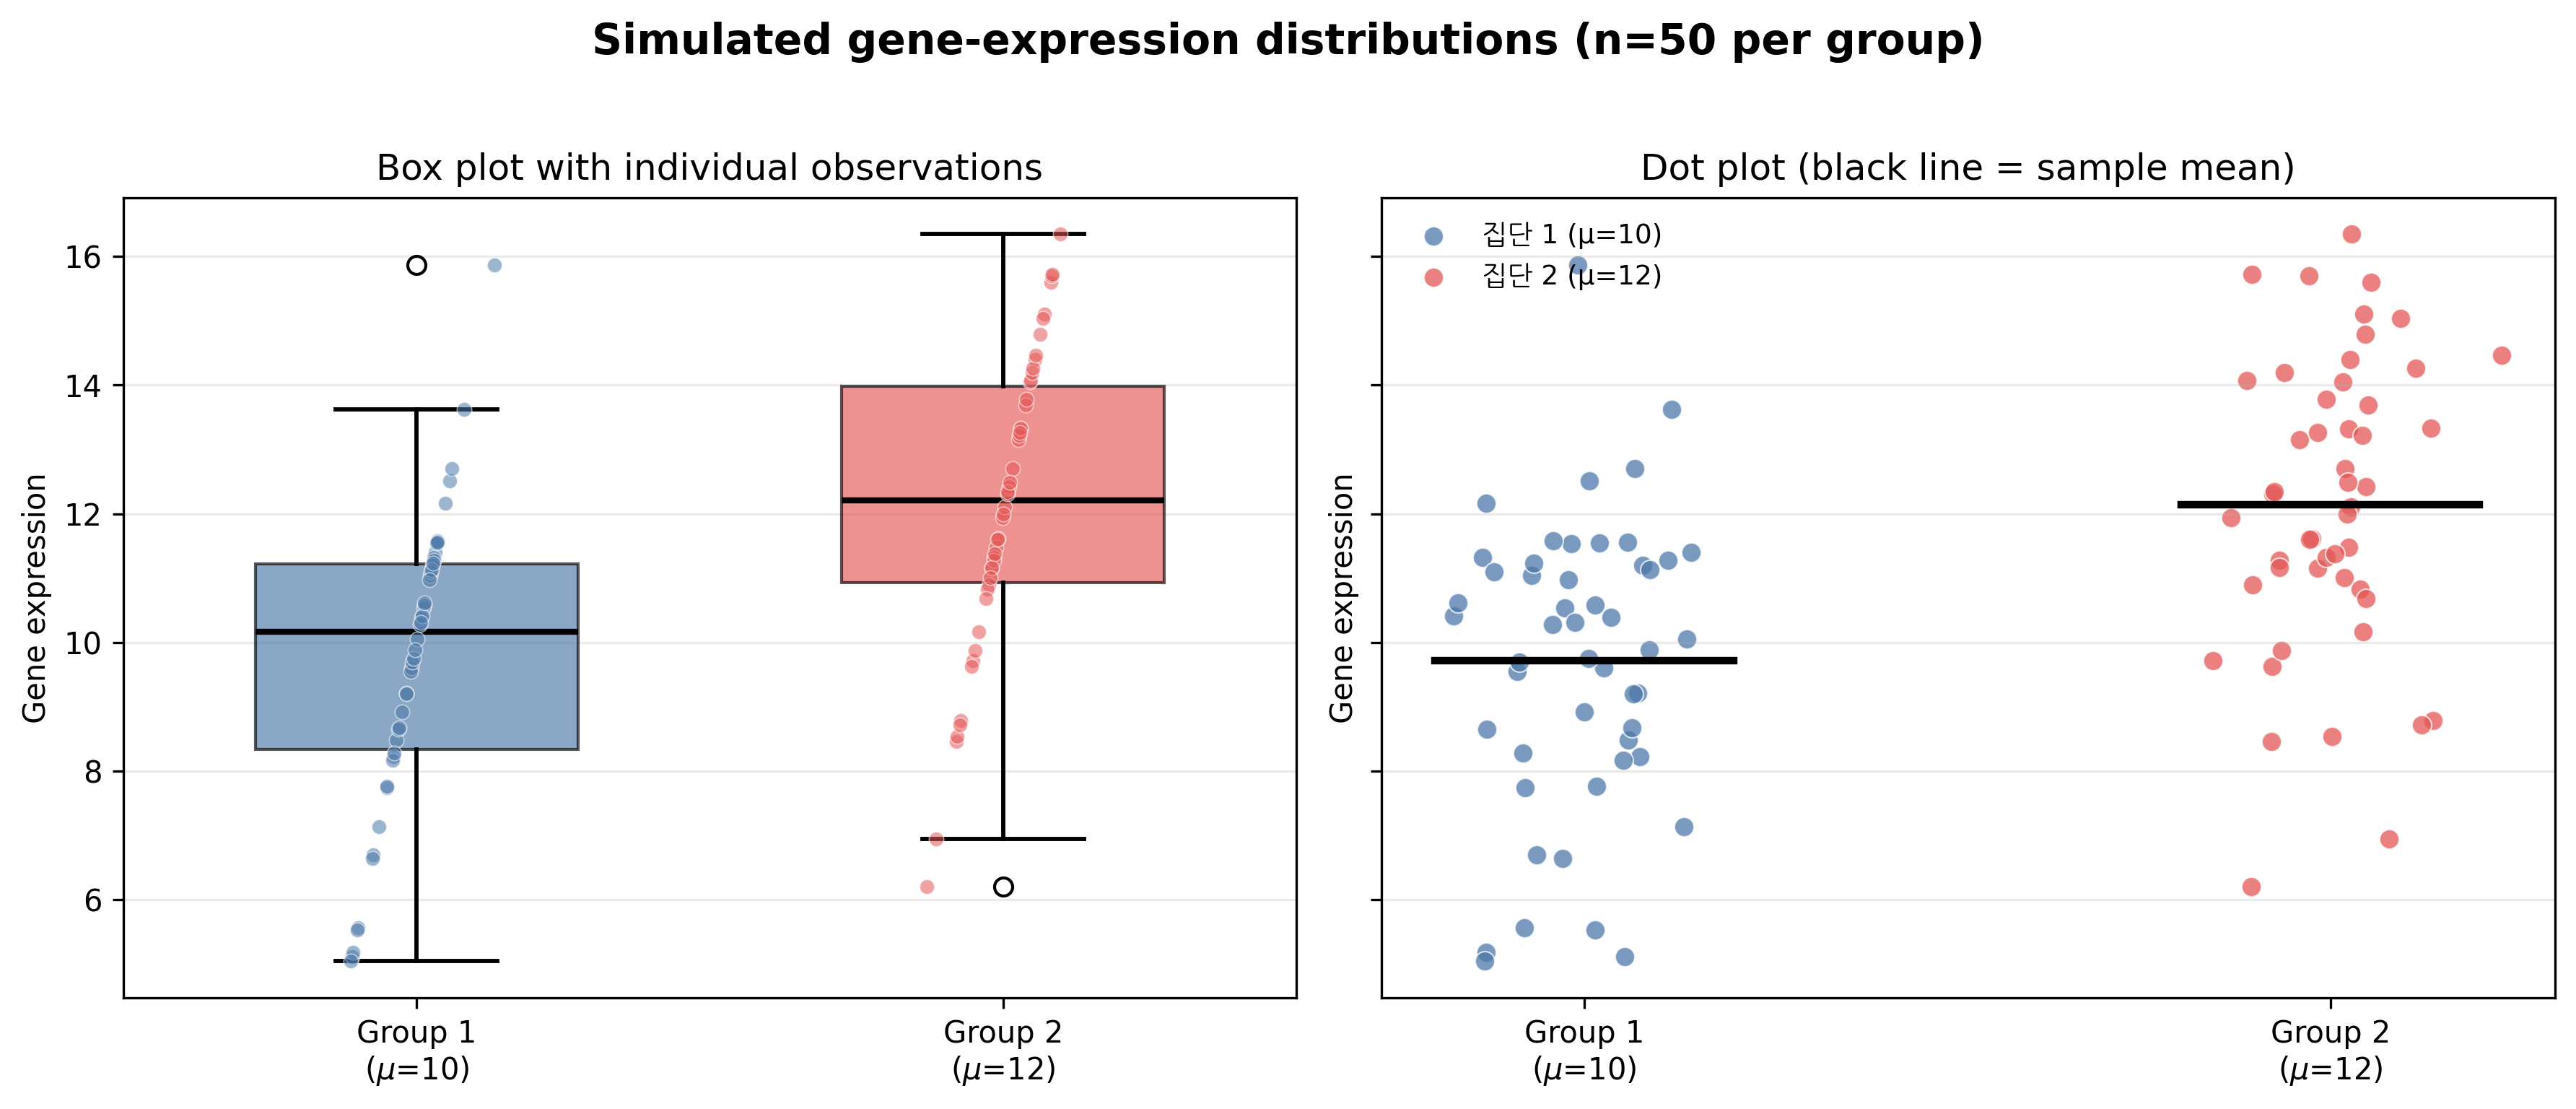
from biomni.tool.support_tools import run_python_repl result = run_python_repl(command=r''' import pandas as pd import numpy as np import matplotlib.pyplot as plt from scipy import stats df = pd.read_csv("simulated_gene_expression.csv", encoding="utf-8-sig") groups = list(df["group"].unique()) vals = [df.loc[df["group"] == g, "expression"].to_numpy() for g in groups] plt.rcParams["font.family"] = "DejaVu Sans" colors = ["#4C78A8", "#E45756"] rng = np.random.default_rng(2025) fig, axes = plt.subplots(1, 2, figsize=(12, 5), sharey=True) # Box plot bp = axes[0].boxplot(vals, patch_artist=True, widths=0.55, medianprops={"color": "black", "linewidth": 2}, whiskerprops={"linewidth": 1.4}, capprops={"linewidth": 1.4}) for box, color in zip(bp["boxes"], colors): box.set_facecolor(color) box.set_alpha(0.65) for i, values in enumerate(vals, start=1): jitter = rng.normal(i, 0.045, len(values)) axes[0].scatter(jitter, values, color=colors[i-1], alpha=0.55, s=24, edgecolor="white", linewidth=0.4, zorder=3) axes[0].set_xticks([1, 2], ["Group 1\n($\\mu$=10)", "Group 2\n($\\mu$=12)"]) axes[0].set_title("Box plot with individual observations") axes[0].set_ylabel("Gene expression") axes[0].grid(axis="y", alpha=0.25) # Dot (strip) plot for i, values in enumerate(vals, start=1): jitter = rng.normal(i, 0.075, len(values)) axes[1].scatter(jitter, values, color=colors[i-1], alpha=0.75, s=42, edgecolor="white", linewidth=0.5, label=groups[i-1]) axes[1].plot([i-0.20, i+0.20], [values.mean(), values.mean()], color="black", linewidth=2.5) axes[1].set_xticks([1, 2], ["Group 1\n($\\mu$=10)", "Group 2\n($\\mu$=12)"]) axes[1].set_title("Dot plot (black line = sample mean)") axes[1].set_ylabel("Gene expression") axes[1].grid(axis="y", alpha=0.25) axes[1].legend(frameon=False, loc="upper left", fontsize=9) fig.suptitle("Simulated gene-expression distributions (n=50 per group)", y=1.02, fontsize=14, fontweight="bold") fig.tight_layout() fig.savefig("gene_expression_boxplot_dotplot.png", dpi=300, bbox_inches="tight") fig.savefig("gene_expression_boxplot_dotplot.pdf", bbox_inches="tight") plt.close(fig) p = stats.ttest_ind(vals[0], vals[1], equal_var=False).pvalue print(f"Welch t-test p-value (full precision): {p:.3e}") print("저장 완료: gene_expression_boxplot_dotplot.png, gene_expression_boxplot_dotplot.pdf") ''') print(result) -
실행 결과
실행 결과 보기
Welch t-test p-value (full precision): 7.560e-07
저장 완료: gene_expression_boxplot_dotplot.png, gene_expression_boxplot_dotplot.pdf
-
파일gene_expression_boxplot_dotplot.pdf
-
파일gene_expression_boxplot_dotplot.png
-
계획1. [✓] 재현 가능하도록 난수를 고정하고, 평균 10 및 12·표준편차 2인 정규분포에서 각 50개의 유전자 발현량을 생성합니다. 2. [✓] 독립표본 Welch t-검정을 수행하고 요약 통계와 검정 결과를 저장합니다. 3. [✓] 두 집단의 분포를 상자그림과 점 그림으로 비교한 그림 및 결과 표를 저장합니다.
두 집단(각 n=50)의 유전자 발현량을 정규분포에서 시뮬레이션했습니다(난수 시드 2025).
| 집단 | 설정 평균 | 표본 평균 ± 표준편차 |
|---|---:|---:|
| 집단 1 | 10 | 9.712 ± 2.286 |
| 집단 2 | 12 | 12.144 ± 2.315 |
**Welch 독립표본 t-검정 (양측)**
- 평균 차이(집단 2 − 집단 1): **2.433**
- t(97.98) = **−5.287**
- p = **7.56 × 10⁻⁷**
- 평균 차이의 95% 신뢰구간: **1.520–3.346**
- Cohen’s d = **1.057** (큰 효과크기)
따라서 시뮬레이션된 데이터에서 집단 2의 유전자 발현량은 집단 1보다 통계적으로 유의하게 높습니다.
생성 파일:
- `simulated_gene_expression.csv`: 개별 시뮬레이션 데이터
- `gene_expression_summary.csv`: 집단별 요약 통계
- `ttest_results.csv`: t-검정 결과
- `gene_expression_boxplot_dotplot.png`: 상자그림 및 점 그림
- `gene_expression_boxplot_dotplot.pdf`: 벡터 형식 그림
simulated_gene_expression.csv
3.49 KB
gene_expression_summary.csv
133 Bytes
ttest_results.csv
317 Bytes
gene_expression_boxplot_dotplot.pdf
33.5 KB
 gene_expression_boxplot_dotplot.png